Tender Radar
KI, die jede EU-IT-Ausschreibung liest und sagt, auf welche sich ein Angebot lohnt, und zu welchem Preis.
Eine KI-Pipeline auf Databricks: Ein LLM übersetzt und ordnet jede EU-IT-Ausschreibung aus 24 Sprachen ein, ein ML-Modell sagt den Zuschlagspreis vorher, und RAG beantwortet Fragen mit Quellen. Jede offene Ausschreibung bekommt jeden Morgen einen Score mit drei Gründen.
- Rolle
- Eigenes Projekt · KI, Data Engineering & ML
- Zeitraum
- 11/2026
Komplett auf Databricks gebaut
Auf der Free Edition: nur Serverless, ein SQL Warehouse, ein AI-Search-Endpoint und ein tägliches Compute-Kontingent. Diese Grenzen haben das Design geprägt.
- Lakeflow Jobs
- Unity Catalog
- Auto Loader
- Delta Lake
- Databricks SQL
- ai_query
- MLflow
- AI Search
- AI/BI Dashboards
- Declarative Automation Bundles
Die Ausgangsfrage
Auf welche EU-IT-Ausschreibungen sollte ein mittelständisches IT-Haus diese Woche bieten, und zu welchem Preis?
Die EU veröffentlicht auf TED jedes Jahr rund 80.000 Ausschreibungen für IT, Software und Beratung, in 24 Sprachen. Ein mittelständisches IT-Haus kann sich auf ein paar im Monat bewerben, und jedes Angebot kostet Tage.
Was ich mich zuerst gefragt habe
Kann man vorhersagen, wer gewinnt?
Nein. Zuschlagsbekanntmachungen nennen nur den Gewinner, nie die anderen Bieter. Und 94 % der Gewinner kommen aus dem Land des Auftraggebers: „immer inländisch“ zu raten wäre schon zu 94 % richtig, und nutzlos.
94 %Gewinner aus dem Inland
Was gibt die Datenlage her?
Den Preis. Der Zuschlagswert steht in 77 % der EU-Zuschläge. Also sagt ein Modell Zuschlag ÷ Schätzwert vorher, und ähnliche frühere Ausschreibungen zeigen, wer sie gewonnen hat.
77 %der Zuschläge mit Preis
Lohnt sich ein Angebot überhaupt?
Oft ja. 40,4 % der vergebenen IT-Ausschreibungen hatten nur einen Bieter, in Kroatien 72,8 %. Und Zuschläge liegen im Median beim 0,83-Fachen des Schätzwerts.
40,4 %mit nur einem Angebot
Was die Daten nicht verraten
- Wer sonst geboten hat, und zu welchem Preis
- Warum der Gewinner gewonnen hat
- Was der Vertrag am Ende wirklich kostet
Consulting-Case
Was das einem Angebotsteam bringt
Tender Radar ist wie ein Kundenprojekt aufgebaut: eine echte Entscheidung (bieten oder nicht), das Firmenprofil als Konfiguration und Zahlen, die ein Bid Manager nachprüfen kann. Für ein mittelständisches IT-Haus in DACH ändert es vier Dinge.
Fokus
1.778 statt 7.918
Der Score filtert die offenen Ausschreibungen auf die, die zu Leistungen, Größe und Märkten passen, jede mit Begründung. Heute sind das 77,5 % weniger zu lesen.
Preis
0,83×
Zuschläge liegen im Median beim 0,83-Fachen des Schätzwerts. Das Modell liefert je Ausschreibung einen wahrscheinlichen Preis: ein Startpunkt fürs Angebot statt Bauchgefühl.
Wo bieten
66 % vs. 16 %
Ein-Bieter-Quote bei Softwarewartung gegenüber Vergabeberatung. Themen und Auftraggeber zeigen, wo wenige Firmen bieten, und lenken den Vertrieb dorthin.
Betrieb
≈ 10 Min.
Serverless-Compute pro Tag auf der Free Edition. Bei einem Kunden deployt dasselbe Bundle aus Git in dessen Workspace.
So würde ich es bei einem Kunden einführen
- 1Profil setzenLeistungen, Heimatmärkte und Größenbereich der Firma als dbt-Variablen. Der Score rechnet sofort neu.
- 2Pilot mit dem Bid TeamVier Wochen die Shortlist neben die tatsächlichen Entscheidungen legen und die Gewichte daran justieren.
- 3ÜbergebenJob, Tests und Dashboard laufen aus Git im Databricks-Workspace des Kunden. Das Team besitzt es, nicht ich.
Die Pipeline
Von 24 Sprachen zu einer Empfehlung
Jeden Morgen um 06:00 läuft ein Lakeflow Job auf der Databricks Free Edition, aus Git deployt. Klick auf einen Schritt.
Was passiert
Die letzten 3 Tage aus der TED Search API und die EZB-Kurse landen als Dateien in einem Unity-Catalog-Volume. So holt ein verpasster Tag sich selbst nach.
Werkzeuge
- Python
- TED API
- Unity Catalog
3 JahreVerlauf seit eForms (10/2023)
Die letzten 3 Tage aus der TED Search API und die EZB-Kurse landen als Dateien in einem Unity-Catalog-Volume. So holt ein verpasster Tag sich selbst nach.
- Python
- TED API
- Unity Catalog
3 JahreVerlauf seit eForms (10/2023)
Ein Lauf braucht etwa 10 Minuten Serverless-Compute. Jeder Schritt ist wiederholbar: Bei einem Fehler wird einfach neu gestartet.
Live-Dashboard
Das Databricks-Dashboard, live
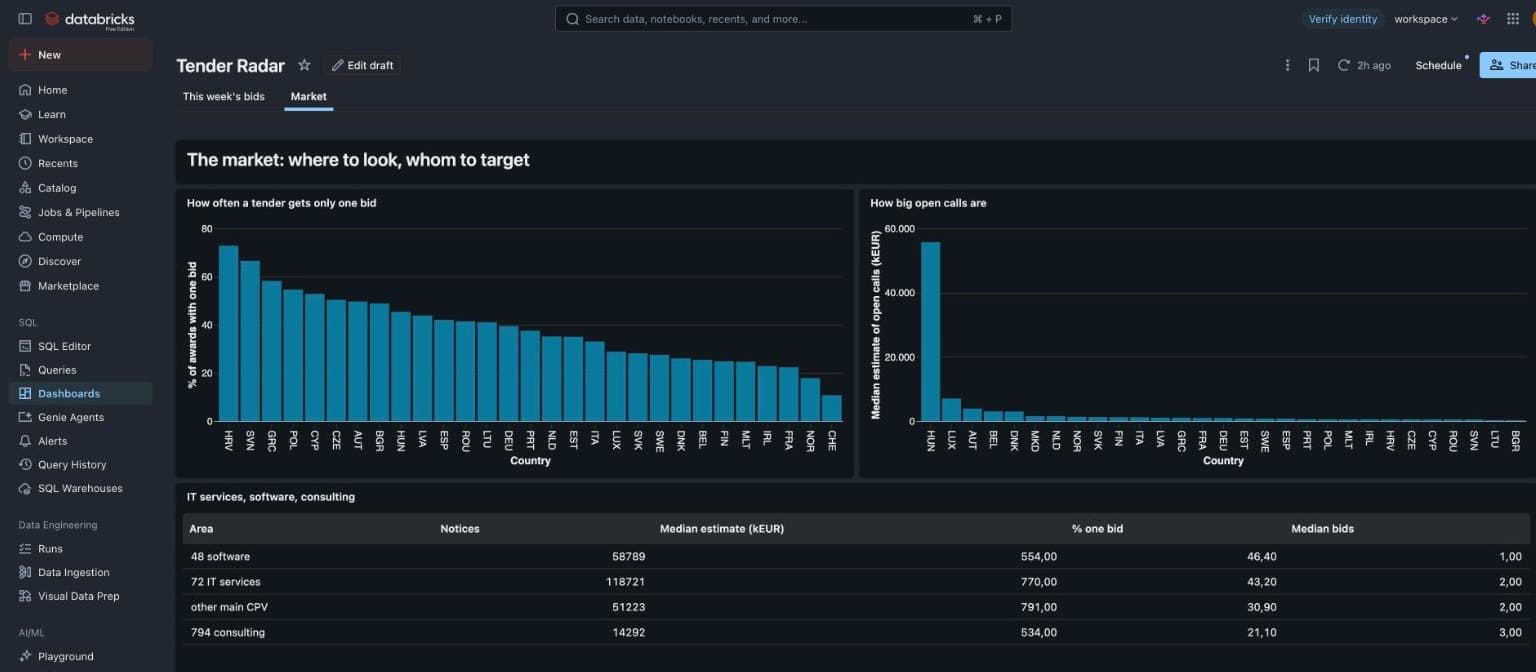
Das ist das AI/BI-Dashboard, das ich in Databricks gebaut habe, 1:1 übernommen: dieselben Inhalte, dieselben 7 SQL-Abfragen auf denselben Gold-Tabellen. Eine GitHub Action führt sie jeden Morgen nach der Pipeline aus, die Seite wird daraus neu gebaut. Die Zahlen sind also dieselben wie im Original.
- Databricks Gold-Tabellen
- 7 SQL-Abfragen
- JSON-Snapshot
- Statische Seite
Tender Radar
Datenstand (Berliner Zeit)
Die Ausschreibungen dieser Woche
Jede offene EU-IT-Ausschreibung, bewertet mit 0–100 Punkten für ein mittelständisches IT-Haus in DACH. Die Gründe sagen, warum. Wahrscheinlicher Zuschlagspreis = Schätzwert × das vom Modell vorhergesagte Verhältnis von Zuschlag zu Schätzwert. Titel kommen auf Englisch aus der Pipeline (LLM-Übersetzung aus 24 Sprachen).
- Offene Ausschreibungen bewertet
- 7.918
- Mit 70 Punkten oder mehr
- 1.778
- KITypischer Zuschlag ÷ Schätzwert (Modell)
- 0,88×
300 Treffer · die besten 300 von 7.918 offenen Ausschreibungen
| Ausschreibung | ||||
|---|---|---|---|---|
| 100 | Bundesministerium für Wirtschaft und Energie · Deutschland | 600.000 € | 586.723 € | 21. Sept. 2026 |
| 97 | IT-Dienstleistungszentrum Berlin (AöR) · Deutschland | 723.800 € | 714.200 € | 6. Okt. 2026 |
| 97 | IT-Dienstleistungszentrum Berlin (AöR) · Deutschland | 415.045 € | 421.140 € | 2. Okt. 2026 |
| 95 | Erste Abwicklungsanstalt AöR · Deutschland | 1.205.600 € | 1.193.865 € | 19. Okt. 2026 |
| 95 | Erste Abwicklungsanstalt AöR · Deutschland | 1.205.600 € | 1.195.045 € | 25. Sept. 2026 |
| 93 | Wiener Tourismusverband · Österreich | 500.000 € | 491.576 € | 16. Okt. 2026 |
| 90 | European Union Aviation Safety Agency · Deutschland | 13.000.000 € | 12.545.806 € | 28. Okt. 2026 |
| 90 | Bundesministerium für Wirtschaft und Energie · Deutschland | 11.764.705 € | 10.863.016 € | 25. Sept. 2026 |
| 90 | Bundesministerium für Wirtschaft und Energie · Deutschland | 11.764.705 € | 10.863.016 € | 16. Okt. 2026 |
| 90 | Priešgaisrinės apsaugos ir gelbėjimo departamentas prie Vidaus reikalų ministerijos · Litauen | 4.380.165 € | 3.986.943 € | 2. Nov. 2026 |
Der Markt: wo suchen, wen ansprechen
Alle IT-, Software- und Beratungsausschreibungen auf TED seit Oktober 2023. DACH, der Heimatmarkt im Bid Score, ist grün markiert.
- Bekanntmachungen seit 10/2023
- 243.025
- Länder mit 50+ Zuschlägen
- 29
- Nur ein Angebot in Kroatien
- 72,8 %
- Kroatien72,8 %
- Slowenien66,5 %
- Griechenland58,2 %
- Polen54,6 %
- Zypern52,8 %
- Tschechien50,3 %
- Österreich49,6 %
- Bulgarien48,8 %
- Ungarn45,3 %
- Lettland43,8 %
- Ungarn55,7 Mio. €
- Luxemburg7 Mio. €
- Österreich3,9 Mio. €
- Belgien3 Mio. €
- Dänemark2,9 Mio. €
- Nordmazedonien1,5 Mio. €
- Niederlande1,5 Mio. €
- Norwegen1,3 Mio. €
- Slowakei1,3 Mio. €
- Finnland1,2 Mio. €
| 72 IT-Services | 118.721 | 770.000 € | 43,2 % | 2 |
|---|---|---|---|---|
| 48 Software | 58.789 | 554.000 € | 46,4 % | 1 |
| Anderer Haupt-CPV | 51.223 | 791.000 € | 30,9 % | 2 |
| 794 Beratung | 14.292 | 534.000 € | 21,1 % | 3 |
72 IT-Services
- Bekanntmachungen
- 118.721
- Median-Schätzwert
- 770.000 €
- Nur ein Angebot
- 43,2 %
- Median Angebote
- 2
48 Software
- Bekanntmachungen
- 58.789
- Median-Schätzwert
- 554.000 €
- Nur ein Angebot
- 46,4 %
- Median Angebote
- 1
Anderer Haupt-CPV
- Bekanntmachungen
- 51.223
- Median-Schätzwert
- 791.000 €
- Nur ein Angebot
- 30,9 %
- Median Angebote
- 2
794 Beratung
- Bekanntmachungen
- 14.292
- Median-Schätzwert
- 534.000 €
- Nur ein Angebot
- 21,1 %
- Median Angebote
- 3
Was der Markt kauft
15 Themen aus k-Means-Clustering auf den Embeddings, benannt vom LLM. Wenigster Wettbewerb zuerst; jede Spalte ist sortierbar.
- KIThemen aus k-Means auf Embeddings
- 15
- Nur ein Angebot: Softwarewartung
- 66,3 %
- Nur ein Angebot: Vergabeberatung
- 16,4 %
| Softwarewartung | 2.275 | 604 | 650.000 € | 66,3 % | 1 | 0,74× |
|---|---|---|---|---|---|---|
| Digitale Transformation | 523 | 156 | 881.000 € | 59,4 % | 1 | 0,85× |
| Verkehrssysteme | 1.970 | 591 | 749.000 € | 50,5 % | 1 | 0,72× |
| Microsoft-Lizenzen | 2.463 | 709 | 660.000 € | 41,9 % | 2 | 0,78× |
| Technischer Support | 2.073 | 460 | 762.000 € | 41,3 % | 2 | 0,58× |
| Rechenzentrum | 2.147 | 574 | 624.000 € | 39,9 % | 2 | 0,88× |
| Server-Hardware | 2.313 | 622 | 496.000 € | 38,7 % | 2 | 0,84× |
| Cybersicherheit | 1.608 | 436 | 612.000 € | 35,8 % | 2 | 0,89× |
Softwarewartung
- Bekanntmachungen
- 2.275
- Offen (60 Tage)
- 604
- Median-Schätzwert
- 650.000 €
- Nur ein Angebot
- 66,3 %
- Median Angebote
- 1
- Zuschlag ÷ Schätzwert
- 0,74×
Digitale Transformation
- Bekanntmachungen
- 523
- Offen (60 Tage)
- 156
- Median-Schätzwert
- 881.000 €
- Nur ein Angebot
- 59,4 %
- Median Angebote
- 1
- Zuschlag ÷ Schätzwert
- 0,85×
Verkehrssysteme
- Bekanntmachungen
- 1.970
- Offen (60 Tage)
- 591
- Median-Schätzwert
- 749.000 €
- Nur ein Angebot
- 50,5 %
- Median Angebote
- 1
- Zuschlag ÷ Schätzwert
- 0,72×
Microsoft-Lizenzen
- Bekanntmachungen
- 2.463
- Offen (60 Tage)
- 709
- Median-Schätzwert
- 660.000 €
- Nur ein Angebot
- 41,9 %
- Median Angebote
- 2
- Zuschlag ÷ Schätzwert
- 0,78×
Technischer Support
- Bekanntmachungen
- 2.073
- Offen (60 Tage)
- 460
- Median-Schätzwert
- 762.000 €
- Nur ein Angebot
- 41,3 %
- Median Angebote
- 2
- Zuschlag ÷ Schätzwert
- 0,58×
Rechenzentrum
- Bekanntmachungen
- 2.147
- Offen (60 Tage)
- 574
- Median-Schätzwert
- 624.000 €
- Nur ein Angebot
- 39,9 %
- Median Angebote
- 2
- Zuschlag ÷ Schätzwert
- 0,88×
Server-Hardware
- Bekanntmachungen
- 2.313
- Offen (60 Tage)
- 622
- Median-Schätzwert
- 496.000 €
- Nur ein Angebot
- 38,7 %
- Median Angebote
- 2
- Zuschlag ÷ Schätzwert
- 0,84×
Cybersicherheit
- Bekanntmachungen
- 1.608
- Offen (60 Tage)
- 436
- Median-Schätzwert
- 612.000 €
- Nur ein Angebot
- 35,8 %
- Median Angebote
- 2
- Zuschlag ÷ Schätzwert
- 0,89×
Auftraggeber, für die sich ein Angebot lohnt
Auftraggeber mit 3+ Zuschlägen und 3+ offenen Ausschreibungen, wenigster Wettbewerb zuerst. Die ersten 100.
- Auftraggeber in der Liste
- 100
- Offene Ausschreibungen bei ihnen
- 1.785
- Davon in DACH
- 11
| Województwo Warmińsko – Mazurskie – Zarząd Dróg Wojewódzkich | Polen | 89 | 16 | 100 % | 1 |
|---|---|---|---|---|---|
| Helios Kliniken GmbH | Deutschland | 52 | 25 | 100 % | 1 |
| Bundesministerium für Wirtschaft und Energie | Deutschland | 52 | 22 | 100 % | 1 |
| "PKP Intercity" S.A. | Polen | 46 | 11 | 100 % | 1 |
| Kasa Rolniczego Ubezpieczenia Społecznego | Polen | 39 | 19 | 100 % | 1 |
| Aplikacje Krytyczne sp. z o.o. | Polen | 37 | 14 | 100 % | 1 |
| InnoBaltica Sp. z o. o. | Polen | 35 | 10 | 100 % | 1 |
| Uniwersytet Medyczny w Łodzi | Polen | 35 | 16 | 100 % | 1 |
| Szpital Specjalistyczny im. Stefana Żeromskiego SPZOZ w Krakowie | Polen | 33 | 11 | 100 % | 1 |
| Investitionsbank Schleswig-Holstein | Deutschland | 27 | 12 | 100 % | 1 |
Województwo Warmińsko – Mazurskie – Zarząd Dróg Wojewódzkich
- Land
- Polen
- Offene Ausschreibungen
- 89
- Zuschläge
- 16
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Helios Kliniken GmbH
- Land
- Deutschland
- Offene Ausschreibungen
- 52
- Zuschläge
- 25
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Bundesministerium für Wirtschaft und Energie
- Land
- Deutschland
- Offene Ausschreibungen
- 52
- Zuschläge
- 22
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
"PKP Intercity" S.A.
- Land
- Polen
- Offene Ausschreibungen
- 46
- Zuschläge
- 11
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Kasa Rolniczego Ubezpieczenia Społecznego
- Land
- Polen
- Offene Ausschreibungen
- 39
- Zuschläge
- 19
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Aplikacje Krytyczne sp. z o.o.
- Land
- Polen
- Offene Ausschreibungen
- 37
- Zuschläge
- 14
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
InnoBaltica Sp. z o. o.
- Land
- Polen
- Offene Ausschreibungen
- 35
- Zuschläge
- 10
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Uniwersytet Medyczny w Łodzi
- Land
- Polen
- Offene Ausschreibungen
- 35
- Zuschläge
- 16
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Szpital Specjalistyczny im. Stefana Żeromskiego SPZOZ w Krakowie
- Land
- Polen
- Offene Ausschreibungen
- 33
- Zuschläge
- 11
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
Investitionsbank Schleswig-Holstein
- Land
- Deutschland
- Offene Ausschreibungen
- 27
- Zuschläge
- 12
- Nur ein Angebot
- 100 %
- Median Angebote
- 1
KI, ML & RAG
Wo die KI arbeitet, und wie ich sie geprüft habe
Jede KI-Komponente hat einen Test gegen etwas Einfaches: eine Handprüfung, eine Baseline oder einen Testsatz mit bekannten Antworten.
Übersetzen und einordnen
20/20
Zusammenfassungen richtig, von Hand geprüft
Llama 3.3 70B macht aus jeder Bekanntmachung in 24 Sprachen einen englischen Titel, eine Zusammenfassung, Technologien und eine Leistungsart.
ai_query direkt im Warehouse, festes JSON-Schema (jede Antwort parst), jede Bekanntmachung nur einmal, offene Ausschreibungen zuerst.
- Titel19/20
- Zusammenfassung20/20
- Technologien19/20
- Leistungsart17/20
Den Zuschlagspreis vorhersagen
−19 %
Fehler (MAE) ggü. der Median-Baseline
Gradient Boosting sagt Zuschlag ÷ Schätzwert vorher. Mal Schätzwert ergibt das den wahrscheinlichen Preis im Dashboard.
Zeitlicher Split: trainiert auf 10/2023–09/2026, getestet auf Oktober 2026. In MLflow geloggt, in Unity Catalog nur registriert, wenn es die Baseline schlägt.
- Baseline (Median)0,299
- Modell0,242
Fragen mit Quellen beantworten
80 %
Recall@6: richtige Quelle unter den 6 Treffern
Eine Frage wie „Cloud-Migration in Deutschland“ findet passende Ausschreibungen per Vektorsuche, und das LLM antwortet nur aus diesen Quellen, mit TED-Link je Aussage.
Embeddings (gte-large-en) in dbt, AI-Search-Index, hybride Suche (Top 6), Antwort mit [n]-Zitaten und einer Prüfung, dass jede Quelle existiert.
- Recall@680 %
- Zitiert die richtige Quelle80 %
- Belegte Antworten100 %
Themen finden
66 %
Ein-Bieter-Quote bei Softwarewartung
k-Means auf denselben Embeddings gruppiert die Ausschreibungen in 15 Themen, die das LLM benennt. So zeigt sich, wo wenig Wettbewerb herrscht.
k = 10 bis 30 getestet, 15 hatte den besten Silhouette-Score. Einmal trainiert, täglich nur zugeordnet: stabile Themen, billiger Tageslauf.
- Softwarewartung66,3 %
- Vergabeberatung16,4 %
Und warum der Bid Score kein Modell ist
Es gibt keine Daten darüber, auf welche Ausschreibungen eine Firma hätte bieten sollen. Ein Modell würde nur so tun, als wüsste es das. Deshalb ist der Score eine offene Formel aus fünf Signalen, und jede Ausschreibung zeigt ihre drei wichtigsten Gründe.
- Passt zu den Leistungen30 Punkte
- Wenig Wettbewerb25 Punkte
- Passende Größe20 Punkte
- Heimatmarkt DACH15 Punkte
- Bekannter Auftraggeber10 Punkte
Was ich gebaut habe
- LLM-Anreicherung mit Llama 3.3 70B über ai_query: englischer Titel, Zusammenfassung, Technologien und Leistungsart aus 24 Sprachen, als JSON nach Schema, von Hand an 20 Ausschreibungen geprüft.
- Preismodell (Gradient Boosting, zeitlicher Split) in MLflow, das Zuschlag ÷ Schätzwert vorhersagt und die Median-Baseline um 19 % MAE schlägt.
- RAG-Chat mit Quellen: Embeddings, Vektorindex mit 29.373 Dokumenten, hybride Suche, Zitat-Prüfung, Recall@6 von 80 %. Dazu 15 Themen per k-Means auf den Embeddings.
- Tägliche Lakehouse-Pipeline als Lakeflow Job: TED-API, Auto Loader nach Bronze, PySpark-Silver in EUR, dbt-Gold mit 6 Modellen und 18 Tests inklusive Leak-Test.
- Transparenter Bid Score aus fünf Signalen mit den drei wichtigsten Gründen in Worten, als AI/BI-Dashboard aus Git deployt und hier aus einem täglichen Snapshot nachgebaut.
Ergebnis
- Jede offene Ausschreibung bewertet, mit drei Gründen in Worten und einem vom Modell vorhergesagten Preis.
- Fragen zu Ausschreibungen in jeder Sprache, beantwortet mit TED-Quellen statt erfundener Antworten.
- Fakten für die Angebotsplanung: 40,4 % der IT-Zuschläge hatten nur ein Angebot.
- Läuft jeden Morgen ohne mich, aus Git deployt, auf der Databricks Free Edition.
Tech-Stack
KI & ML
Übersetzung per LLM, Preismodell, Themen und RAG-Suche mit Quellen.
- ai_query
- Llama 3.3 70B
- scikit-learn
- MLflow
- AI Search
- gte-large-en
Ingest & Lakehouse
Neue Bekanntmachungen jeden Morgen von Bronze bis Silver, mit EUR-Umrechnung.
- Python
- Auto Loader
- Delta Lake
- PySpark
- Unity Catalog
Gold & Qualität
Getestete Gold-Tabellen für Modell, Suche, Score und Dashboard.
- dbt
- SQL
- Databricks SQL
Betrieb & Ausgabe
Täglicher Job aus Git, Dashboard und dieser Snapshot-Export.
- Lakeflow Jobs
- Declarative Automation Bundles
- AI/BI Dashboards
- GitHub Actions
- Next.js